 Harnessing
Human in the loop: come sai che l’agente ha fatto un buon lavoro
Human in the loop significa tenere la persona nel punto giusto del processo, non ovunque. La parte difficile di un agente AI non è farlo funzionare, è sapere che ha funzionato: ecco come si verifica il lavoro e quanto costa fidarsi.
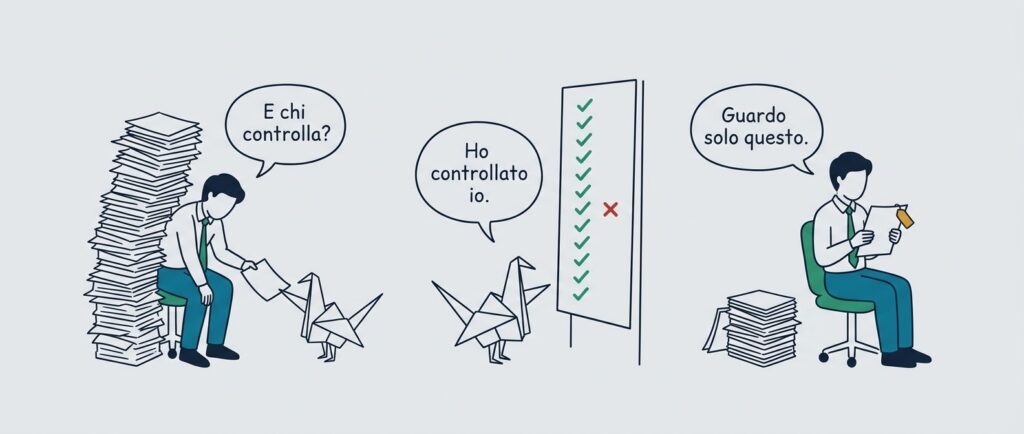
La parte difficile di un agente AI non è farlo funzionare. È sapere che ha funzionato. Un agente che lavora duecento pratiche in un’ora crea valore solo se qualcuno può dire, con ragionevole certezza, che quelle duecento pratiche sono giuste. Altrimenti il lavoro non è stato tolto: è stato spostato, da chi lo faceva a chi adesso deve controllarlo.
Human in the loop, letteralmente umano nel ciclo, indica un sistema in cui una persona resta dentro il processo decisionale della macchina invece di limitarsi a riceverne il risultato. Il significato è semplice. Il difficile è il dove: in quale punto esatto serve l’occhio umano, quanto spesso, e su che cosa. Metterlo dappertutto azzera il guadagno. Non metterlo affatto scarica il rischio a valle, di solito sul cliente finale.
Questo articolo parla di quella decisione. È il punto in cui si separa chi costruisce agenti che reggono la produzione da chi fa demo che funzionano il giorno della presentazione.
Il problema non è l’errore, è l’errore plausibile
Un agente che si blocca non fa danni: lo vedi. Un agente che produce un documento palesemente assurdo non fa danni: lo vedi. Il rischio vero ha un’altra forma, ed è l’output ben scritto, coerente, formattato bene e sbagliato in un punto solo.
È qui che i sistemi generativi si comportano diversamente dal software tradizionale. Un gestionale che sbaglia un calcolo produce un numero fuori scala, e salta all’occhio. Un modello linguistico produce un testo che ha esattamente lo stesso aspetto di quello giusto. La letteratura sull’argomento lo nota con chiarezza: gli assistenti generativi amplificano l’eccesso di fiducia proprio perché restituiscono raccomandazioni narrative e sofisticate, mentre i sistemi automatici della generazione precedente restituivano classificazioni secche accompagnate da un punteggio di confidenza.
È il fenomeno che si sente chiamare allucinazioni: il modello produce un’informazione inventata con la stessa sicurezza con cui produce quelle vere. La parola è fuorviante, perché suggerisce un guasto occasionale, mentre si tratta di una caratteristica strutturale di come questi sistemi generano testo. Non si elimina con un prompt migliore. Si contiene con l’architettura intorno al modello, che è poi l’oggetto di questo articolo.
Tradotto per chi deve decidere: il problema non è la percentuale di errore, è la visibilità dell’errore. Un sistema che sbaglia il 5 per cento delle volte in modo evidente è governabile. Un sistema che sbaglia il 2 per cento delle volte in modo invisibile non lo è.
Il conto che quasi nessuno fa
Prima di parlare di tecniche, serve mettere in fila un’aritmetica che nelle presentazioni commerciali non compare quasi mai.
Il valore di un agente non è quanto lavoro fa. È quanto poco costa fidarsi di quel lavoro.
Scritto come una formula: valore netto = lavoro risparmiato meno costo della verifica. Un agente che redige una lettera in dieci secondi, ma il cui risultato richiede venti minuti di controllo riga per riga, ha valore netto negativo. La persona prima ci metteva quindici minuti a scriverla e basta.
Ne discende la conseguenza che orienta tutto il lavoro di implementazione. La buona progettazione di un agente non massimizza quanto l’agente riesce a fare. Minimizza quanto costa fidarsi di ciò che ha fatto. Sono due obiettivi diversi, e portano ad architetture diverse.
È anche il motivo per cui gli agenti che scrivono codice hanno funzionato prima e meglio di tutti gli altri. Non perché i modelli siano particolarmente bravi a programmare, ma perché il codice ha la verifica incorporata: il compilatore e i test danno un verdetto gratuito, immediato e non opinabile. Il costo della verifica in quel dominio tende a zero. Il mestiere consiste nel ricreare quella condizione dove non esiste già.
La trappola: l’occhio che smette di guardare
La risposta istintiva alla domanda sulla fiducia è: mettiamo una persona a controllare tutto. È la risposta che rassicura in riunione ed è, tra tutte, quella che funziona peggio.
Il fenomeno ha un nome studiato da decenni, prima ancora dell’AI generativa: automation bias. Chi supervisiona un sistema che di solito ha ragione tende ad attribuire un peso eccessivo alla raccomandazione automatica e a ridurre la verifica indipendente. L’effetto peggiora sotto carico cognitivo, cioè esattamente nelle giornate piene in cui il controllo servirebbe di più. Il risultato che la ricerca descrive è netto: la supervisione umana diventa procedurale invece che sostanziale. Un timbro, non un controllo.
Chi ha lavorato in uno studio o in un back office lo riconosce senza bisogno di studi. Alla ventesima pratica identica che risulta corretta, la venticinquesima si firma. Non per negligenza: perché è così che funziona l’attenzione umana.
Da qui la regola controintuitiva che applichiamo nei progetti: un controllo umano al cento per cento non è il massimo della sicurezza, è quasi sempre il minimo. Costa il massimo e, dopo poche settimane, verifica il minimo.
Cinque leve per abbassare il costo della verifica
Se il problema è il costo della verifica, il lavoro consiste nell’abbassarlo. Ci sono cinque leve, in ordine di convenienza.
1. Rendere il lavoro verificabile per costruzione
La leva più potente non si applica dopo, si applica quando si decide la forma del compito. Un agente a cui si chiede il fatturato del trimestre restituisce un numero, e quel numero per controllarlo va rifatto. Un agente a cui si chiede la query che calcola il fatturato del trimestre restituisce una cosa che si legge in venti secondi, si esegue e si riesegue domani.
Stesso lavoro, costo di verifica diverso di un ordine di grandezza. Ogni volta che è possibile far produrre all’agente il procedimento invece del risultato, o il risultato accompagnato dalle sue fonti puntuali, si è spostato il problema nel campo giusto.
2. I check deterministici
Sono la parte meno affascinante e la più redditizia. Una quota sorprendente di ciò che può andare storto non ha bisogno di AI per essere intercettata: totali che devono quadrare, date che devono stare in un intervallo, codici fiscali che devono essere formalmente validi, un contratto a termine che non può finire prima di iniziare, un importo che non può superare il massimale.
Sono controlli scritti una volta, che girano su ogni singolo output, non costano nulla e non si stancano mai. Prima di costruire qualunque valutazione sofisticata conviene esaurire questo elenco, perché intercetta la maggior parte degli errori che arrivano davvero in produzione.
3. Il golden set e le evals
Le evals sono l’esame che il sistema rifà a ogni modifica: un insieme di casi reali con la risposta attesa, che gira automaticamente ogni volta che si tocca un prompt, si cambia modello o si aggiunge uno strumento. Senza, ogni miglioramento è una scommessa e ogni regressione si scopre dal cliente.
Due accorgimenti che fanno la differenza fra evals utili ed evals decorative. Il primo: il verdetto deve essere binario, passa o non passa, non un voto da uno a cinque. La differenza fra un tre e un quattro è rumore su cui non si decide niente, mentre un giudizio binario obbliga a chiarire il criterio. Il secondo: ogni verdetto va accompagnato dalla motivazione scritta, perché è il modo per costringere l’esperto di dominio a esplicitare le regole che ha in testa e non ha mai scritto da nessuna parte.
E prima ancora delle metriche viene l’analisi degli errori, cioè guardare i casi veri uno per uno e raggrupparli per tipo. È un lavoro noioso con un rendimento sproporzionato: nei casi documentati in letteratura poche categorie di errore spiegano la maggior parte dei problemi, e sistemarne una sola può spostare il tasso di successo di decine di punti. Chi salta questo passaggio finisce a ottimizzare metriche che non corrispondono a niente.
4. Il giudice automatico, e i suoi difetti
Su ciò che non si misura con una regola secca, per esempio se una risposta è completa o il tono è adeguato, si usa un secondo modello come giudice. Funziona, a due condizioni che vengono ignorate spesso.
La prima: il giudice non deve essere lo stesso modello che ha prodotto il lavoro. I modelli mostrano un bias di auto-promozione, cioè valutano meglio i propri output. Insieme a quello convivono un bias di posizione, la tendenza a preferire la risposta vista per prima o per ultima, e un bias di lunghezza, la tendenza a premiare la risposta più lunga a parità di contenuto.
La seconda: il giudice va tarato contro giudizi umani, misurando quanto spesso è d’accordo con una persona competente. È utile sapere dove sta l’asticella: due valutatori umani che guardano lo stesso materiale con lo stesso criterio sono d’accordo circa l’ottanta per cento delle volte, e i giudici automatici migliori si collocano su valori paragonabili. Quindi un giudice automatico ben costruito non è peggio di un revisore umano, ma quell’ottanta per cento resta un soffitto: una valutazione su cinque è discutibile. Nei domini specialistici l’esperto va tenuto dentro il ciclo, perché è documentato che le preferenze degli specialisti e quelle dei modelli divergono proprio sui casi tecnici.
5. Guardare la strada, non solo l’arrivo
Un agente compie molti passi prima di consegnare: sceglie strumenti, li interroga con certi parametri, legge, decide il passo dopo. Valutare solo il risultato finale dice se qualcosa è andato storto, non dove.
C’è una ragione più seria per guardare il percorso. Un risultato giusto raggiunto per la strada sbagliata è un falso positivo: il sistema è stato fortunato una volta, e la fragilità che l’ha reso fortunato riemergerà in condizioni leggermente diverse. Sul percorso si controllano due cose concrete: che sia stato scelto lo strumento giusto, e che gli siano stati passati i parametri giusti.
Human in the loop: dove si mette la persona
Torniamo alla domanda iniziale. Human in the loop non vuol dire un umano che ricontrolla tutto, vuol dire un umano collocato dove la sua attenzione rende di più. Le posizioni che funzionano sono quattro, e si combinano.
- Sull’eccezione, non sulla norma. L’agente elabora il caso standard e ferma da solo quello anomalo. È il compito dei guardrail: soglie oltre le quali il sistema non decide, ma chiede. Un importo fuori scala, un cliente mai visto, una clausola che non rientra nei modelli noti.
- Sul campione, con criterio. Una quota di pratiche estratta e controllata davvero, con l’esito che torna dentro il golden set. Meglio dieci casi guardati bene di duecento sfogliati, perché i duecento sfogliati sono automation bias in azione.
- Sulla decisione, mai sull’esecuzione. Se una cosa è irreversibile, cioè un invio a un cliente, un pagamento, una comunicazione a un ente, l’ultimo clic resta a una persona. Non perché l’agente sbagli più di un umano, ma perché il costo dell’errore è asimmetrico.
- A monte, sui criteri. È la posizione più sottovalutata e la più produttiva: l’esperto non controlla gli output uno per uno, definisce e aggiorna le regole con cui vengono controllati. Il suo tempo va nelle evals, non nella revisione.
La differenza fra le prime tre e la quarta è quella fra un umano che fa da rete e un umano che fa da progettista. La rete si logora. Il progettista compone. Il principio human in the loop, applicato bene, sposta le persone dalla prima posizione alla seconda: meno tempo a ricontrollare, più tempo a decidere che cosa va controllato.
Cosa farsi mostrare da chi ti vende un agente
Se stai valutando un fornitore, la demo dice poco: è costruita sui casi che funzionano. Queste cinque domande dicono molto di più, e la qualità delle risposte separa i professionisti dagli entusiasti.
- Su quali casi lo avete misurato, e posso vederli? Se non esiste un insieme di casi con risposta attesa, non esiste una misura, esiste un’impressione.
- Cosa succede quando sbaglia? Un fornitore serio ha una risposta pronta, perché ha già visto il sistema sbagliare. Chi dice che non sbaglia non lo ha osservato abbastanza.
- Come me ne accorgo io, senza rifare il lavoro? È la domanda sul costo della verifica. Se l’unico modo di accorgersene è ricontrollare tutto, il progetto non sta in piedi economicamente.
- Dove si ferma da solo? Un agente senza punti di arresto dichiarati è un agente che non è stato pensato per la produzione.
- Chi controlla il controllore? Se la valutazione è affidata a un modello, come è stato verificato che quel giudizio corrisponde a quello di una persona competente?
C’è anche un motivo normativo per porsele. L’AI Act europeo, per i sistemi classificati ad alto rischio, non si limita a suggerire la sorveglianza umana: la richiede, e richiede che sia effettiva, cioè che la persona sia messa nelle condizioni di capire il sistema, interpretarne gli output e intervenire. Una supervisione che nei fatti è un timbro non soddisfa quel requisito. Il che riporta al punto di prima: la sorveglianza umana non è una casella da spuntare, è una cosa da progettare.
Come lo facciamo nei nostri progetti
Due esempi concreti, entrambi raccontati per esteso altrove sul sito.
Nell’osservatorio del turismo di UMBRA il problema era la fiducia in un numero mostrato in chat. La soluzione non è stata chiedere all’utente di credere: lo stesso indicatore viene calcolato da tre fonti indipendenti e il sistema pretende scarto zero. Se le tre fonti divergono, il dato non viene mostrato, viene segnalato. Il costo della verifica per chi legge scende a zero, perché la verifica è avvenuta prima.
Nel caso dello studio di consulenza del lavoro la leva è stata la seconda dell’elenco. Date, scadenze, coerenza fra tipo di contratto e durata, congruenza degli importi: sono controlli deterministici che girano prima che la lettera esista. All’operatore non arriva un documento da verificare, arriva un documento già passato attraverso i controlli che avrebbe fatto lui, più le eccezioni evidenziate.
In entrambi i casi la struttura è la stessa e vale la pena isolarla: il lavoro di verifica non è stato eliminato, è stato spostato prima e a monte, dove si paga una volta sola invece che a ogni pratica. È la parte del metodo che chiamiamo harnessing a cui dedichiamo più tempo, e non a caso è quella che i clienti non chiedono mai nel preventivo iniziale. In entrambi i progetti la persona è rimasta nel ciclo, ma in un punto solo e scelto.
Quando la risposta giusta è no
C’è un corollario che va detto, perché è quello che ci fa rinunciare a dei progetti.
Se in un certo compito non esiste alcun modo economico di stabilire se il risultato è giusto, quel compito non è pronto per un agente. Non è un limite dei modelli di oggi che passerà con quelli di domani: è una proprietà del compito. Dove non c’è verifica possibile non c’è affidabilità dimostrabile, e senza affidabilità dimostrabile l’automazione trasferisce solo il rischio.
Per questo la prima domanda che facciamo su un processo non è se un agente saprebbe farlo. È come faremmo a sapere che lo ha fatto bene. Se a quella domanda non c’è una risposta praticabile, il processo resta alle persone, e lo diciamo prima di firmare invece che dopo.
È esattamente l’esercizio della diagnosi gratuita di quarantacinque minuti: prendiamo i processi veri e li passiamo da questo filtro. Chi vuole prima capire di cosa stiamo parlando può partire da cos’è un agente AI e dal metodo completo.